
Quellen
Einleitung
In einer Welt, in der Technologie unser tägliches Leben durchdringt, stehen wir vor einer alarmierenden Realität:
Unsere persönlichen Daten werden zunehmend ohne unser ausdrückliches Einverständnis von Tech-Giganten wie Meta für das Training künstlicher Intelligenzen (KI) genutzt.
Dieser Beitrag beleuchtet die aktuellen Entwicklungen, die ethischen Bedenken und die Auswirkungen auf unsere Privatsphäre.
Der aktuelle Stand: Meta und das KI-Training mit Nutzerdaten
Meta, das Unternehmen hinter Facebook, WhatsApp und Instagram, hat angekündigt, ab dem 27. Mai 2025 sämtliche öffentlich geteilten Inhalte erwachsener Nutzer in der EU – darunter Beiträge, Fotos und Kommentare – für das Training seiner KI-Modelle zu verwenden.
Private Nachrichten sollen zwar ausgenommen sein, doch Datenschützer kritisieren, dass auch sensible Informationen betroffen sein könnten.
Die Verbraucherzentrale Nordrhein-Westfalen hat Meta daher abgemahnt und fordert eine Unterlassungserklärung . Auch die Datenschutz-NGO NOYB, gegründet von Max Schrems, hat Beschwerden in mehreren europäischen Ländern eingereicht.
Das Problem mit dem „berechtigten Interesse“
Meta beruft sich auf das sogenannte „berechtigte Interesse“ gemäß Artikel 6 Absatz 1 lit. f der DSGVO, um die Verarbeitung der Daten zu rechtfertigen.
Datenschützer argumentieren jedoch, dass dies nicht ausreicht, insbesondere wenn sensible Daten betroffen sind. Die DSGVO verlangt in solchen Fällen eine ausdrückliche Einwilligung der Nutzer.
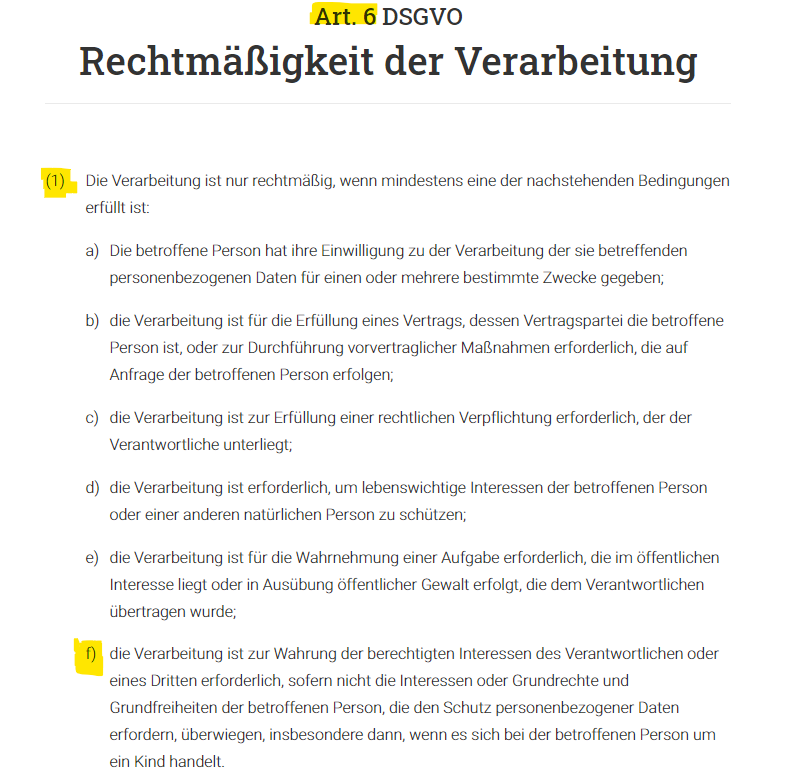
Quelle: DSGVO
Die Rolle von Datenbrokern und der Verkauf persönlicher Informationen
Abseits von Meta existiert ein florierender Markt für persönliche Daten.
Datenbroker sammeln und verkaufen Informationen über unser Online-Verhalten, unsere Vorlieben und sogar unsere Gesundheitsdaten.
Diese Daten können von Unternehmen genutzt werden, um KI-Modelle zu trainieren, die uns noch besser verstehen und beeinflussen können.
Oder auch von Threat-Actors (Angreifer wie Hacker) können solche Daten genutzt werden um mehr über ihr Ziel in Erfahrung zu bringen.
Die Auswirkungen auf unsere Privatsphäre
Die Nutzung unserer Daten für KI-Training hat weitreichende Konsequenzen:
- Verlust der Kontrolle: Wir wissen oft nicht, welche Daten gesammelt werden und wie sie verwendet werden.
- Manipulation: KI-Systeme könnten genutzt werden, um unser Verhalten zu beeinflussen, sei es durch personalisierte Werbung oder gezielte Desinformation.
- Diskriminierung: Fehlerhafte oder voreingenommene Daten können zu diskriminierenden Entscheidungen führen, etwa bei Bewerbungen oder Kreditvergaben.
Was können wir tun?
Es ist wichtig, dass wir uns unserer Rechte bewusst sind und aktiv handeln:
- Widerspruch einlegen: Meta bietet ein Formular an, mit dem Nutzer der Verwendung ihrer Daten widersprechen können.
- Datenschutz-Einstellungen prüfen: Regelmäßiges Überprüfen und Anpassen der Privatsphäre-Einstellungen auf sozialen Plattformen kann helfen, die Sichtbarkeit unserer Daten zu kontrollieren.
- Bewusstsein schaffen: Indem wir über diese Themen sprechen und informieren, können wir Druck auf Unternehmen und Gesetzgeber ausüben, um strengere Datenschutzrichtlinien durchzusetzen.
Fazit
Die Nutzung unserer persönlichen Daten für das Training von KI-Systemen stellt eine ernsthafte Bedrohung für unsere Privatsphäre dar. Es liegt an uns, wachsam zu bleiben, unsere Rechte wahrzunehmen und für den Schutz unserer Daten einzutreten. Nur so können wir sicherstellen, dass technologische Fortschritte nicht auf Kosten unserer persönlichen Freiheit gehen.